
Argo Workflows löst das als container-native Workflow-Engine: Dieser Guide zeigt, wie sich DAGs, Daten-Pipelines und komplexe Batch-Jobs deklarativ und transparent auf Kubernetes umsetzen lassen.
Das Problem: Die Grenzen von einfachen Kubernetes Jobs
Kubernetes stellt mit Job- und CronJob-Ressourcen solide Grundlagen bereit, um einmalige oder zeitgesteuerte Aufgaben in Containern auszuführen. Sobald Anforderungen jedoch über das Ausführen eines einzelnen Pods hinausgehen, werden diese Basiswerkzeuge schnell unzureichend.
Typische Herausforderungen in der Praxis:
- Fehlende Abhängigkeiten: Task B darf erst starten, wenn Task A erfolgreich beendet wurde. K8s-Jobs bieten von Haus aus keine Möglichkeit, solche Verknüpfungen abzubilden.
- Keine Daten- und Artefaktweitergabe: Zwischenergebnisse einer Berechnung (z. B. eine verarbeitete Datei oder eine generierte ID) lassen sich nicht ohne Weiteres von einem Pod an den nächsten übergeben.
- Mangelnde Fehlerbehandlung: Fällt ein Teilschritt in einer mehrstufigen Kette aus, muss oft der gesamte Prozess von vorne begonnen werden, da feingranulare Retry-Logiken pro Schritt fehlen.
- Fehlende Transparenz: Bei Dutzenden parallel laufenden Pods geht in der Standard-K8s-Sicht rasch die Übersicht verloren, an welcher Stelle eine Pipeline gerade steckt oder blockiert.
Viele Teams behelfen sich in solchen Situationen mit komplexen Wrapper-Skripten, missbrauchen externe CI/CD-Tools für Batch-Processing oder betreiben aufwändige eigene Orchestrator-Services.
Die Lösung: Was ist Argo Workflows?
Nachdem im ersten Teil dieser Serie Argo CD für den Zustand (Desired State) und im zweiten Teil Argo Events für das Signal (Triggering) vorgestellt wurden, übernimmt Argo Workflows den dritten zentralen Baustein der Plattform: die Ausführung (Execution) komplexer, mehrstufiger Logik.
Man kann sich Argo Workflows wie eine automatisierte Produktionsstrasse im werkseigenen Betrieb vorstellen: Ein Rohstoff trifft ein und passiert nacheinander verschiedene spezialisierte Stationen. Bei Bedarf teilt sich das Fliessband für parallele Verarbeitungsschritte auf, führt Zwischenprodukte an einer Montagestation wieder zusammen und übergibt das Endergebnis an das Lager. Jede Station arbeitet isoliert, ist aber genau auf die vorangehenden und nachfolgenden Schritte abgestimmt.
Argo Workflows ist eine native, Open-Source-Workflow-Engine für Kubernetes. Jeder einzelne Schritt innerhalb eines Workflows wird als vollkommen isolierter Kubernetes-Pod ausgeführt. Dadurch lässt sich jeder Teilschritt individuell skalieren, mit spezifischen Ressourcen (CPU/RAM/GPU) ausstatten und deklarativ via YAML steuern.
Die Architektur: Die wichtigsten Bausteine
Argo Workflows basiert auf wenigen, mächtigen Custom Resources, die komplexe Prozessketten strukturiert abbilden:
- 1. Workflow: Das zentrale Objekt, das eine konkrete Ausführung einer Pipeline definiert und startet.
- 2. WorkflowTemplate: Eine wiederverwendbare Vorlage (Blaupause) für Prozesse, die parametrisiert und aus verschiedenen Systemen heraus aufgerufen werden kann.
- 3. Steps vs. DAGs (Orchestrierungs-Logik):
- Steps: Sequenzielle oder einfache parallele Listen von Schritten (Schritt A -> Schritt B -> Schritt C).
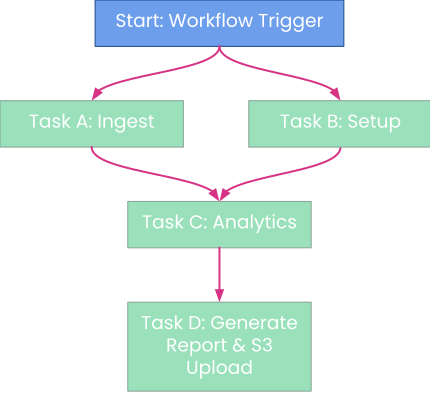
- DAGs (Directed Acyclic Graphs): Graphbasierte Abhängigkeiten. Schritte werden auf Basis gerichteter Graphen ausgeführt (z. B. “Führe Task C aus, sobald Task A und Task B erfolgreich abgeschlossen sind”).
- 4. Parameters & Artifacts: Steuern den Datenfluss. Parameter übergeben Strings und Umgebungsvariablen; Artefakte leiten ganze Dateien oder Ordner (z. B. über S3/MinIO) transparent von einem Pod zum nächsten weiter.
Ablauf eines DAG-Workflows
Ein einfaches Beispiel: Ein DAG-Workflow in YAML
Voraussetzung: Die Argo Workflows CRDs und Controller müssen bereits im Cluster installiert sein. Ein Service Account
argo-workflowmuss erstellt werden, und die folgende ClusterRole berechtigt für die Ausführung von Workflows.
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: workflow-executor-rbac
rules:
  - apiGroups:
      - argoproj.io
    resources:
      - workflowtaskresults
    verbs:
      - create
      - patch
Das folgende Beispiel zeigt einen DAG-Workflow, bei dem zwei Aufgaben (task-a und task-b) parallel ausgeführt werden, bevor die finale Aufgabe (task-c) startet.
apiVersion: argoproj.io/v1alpha1
kind: Workflow
metadata:
  generateName: dag-pipeline-
  namespace: argo
spec:
  serviceAccountName: argo-workflow
  entrypoint: main-pipeline
  templates:
  - name: main-pipeline
    dag:
      tasks:
      - name: task-a
        template: worker-step
        arguments:
          parameters: [{name: message, value: "Daten aus Quelle A laden"}]
      - name: task-b
        template: worker-step
        arguments:
          parameters: [{name: message, value: "Daten aus Quelle B laden"}]
      - name: task-c
        dependencies: [task-a, task-b]
        template: worker-step
        arguments:
          parameters: [{name: message, value: "Aggregation nach A und B durchführen"}]

  - name: worker-step
    inputs:
      parameters:
      - name: message
    container:
      image: alpine:latest
      command: [sh, -c]
      args: ["echo {{inputs.parameters.message}} && sleep 2"]
Was hier passiert: task-a und task-b starten gleichzeitig in zwei separaten Pods. Erst wenn beide Pods erfolgreich beendet wurden, erzeugt der Controller den Pod für task-c. Über die Benutzeroberfläche von Argo Workflows lässt sich dieser Graph live und farblich kodiert nachverfolgen.
Typische Anwendungsfälle: Wann lohnt sich Argo Workflows?
In Cloud-Native-Umgebungen deckt Argo Workflows eine Vielzahl von Anwendungsfällen ab, bei denen einfache Kubernetes Jobs nicht ausreichend sind:
- ETL- & Datenverarbeitungs-Pipelines: Strukturierte Extraktion, Transformation und das Laden grosser Datenmengen in mehreren Teilschritten.
- Machine Learning Pipelines: Von der Datenbereinigung über das parallele Modelltraining (z. B. auf GPU-Knoten) bis hin zur Evaluation und Registrierung des Modells.
- Komplexe CI/CD- & Test-Pipelines: Paralleles Bauen von Artefakten, Ausführen von Integrationstests in isolierten Umgebungen und anschliessendes Scannen auf Sicherheitslücken.
- Infrastruktur- & Wartungs-Tasks: Regelmässige, mehrstufige Aufräumarbeiten, Datenbank-Backups mit Integritätsprüfung oder Cluster-Wartungsaufgaben.
Fazit & Ausblick
Argo Workflows beendet die Behelfslösungen rund um einfache Kubernetes-Jobs, unübersichtliche Wrapper-Skripte und ortsfremde CI/CD-Tools für Batch-Processing. Als container-native Workflow-Engine bringt das Tool strukturierte Orchestrierung, feingranulare Fehlerbehandlung und volle Transparenz direkt in den Cluster.
Ob verzweigte DAGs, datenintensive ETL-Pipelines oder parallele Test-Abläufe: Jeder Teilschritt läuft isoliert in eigenen Pods, lässt sich individuell skalieren und bleibt über Manifeste wie gewohnt deklarativ steuerbar. Damit wird Kubernetes von einer reinen Container-Laufzeitumgebung zu einer vollwertigen, hochskalierbaren Ausführungsplattform für vielschichtige Prozessketten.
Ob strategische Architektur-Beratung oder tatkräftige Hands-on-Unterstützung direkt in eurem Cloud-Native-Projekt: Sprich unser Team gerne an, um komplexe Workflows nachhaltig, effizient und transparent auf Kubernetes umzusetzen.